Wie BERD@NFDI die BWL datenfit machen will
Ulrich Krieger über neue Infrastrukturen für die Wirtschaftswissenschaften
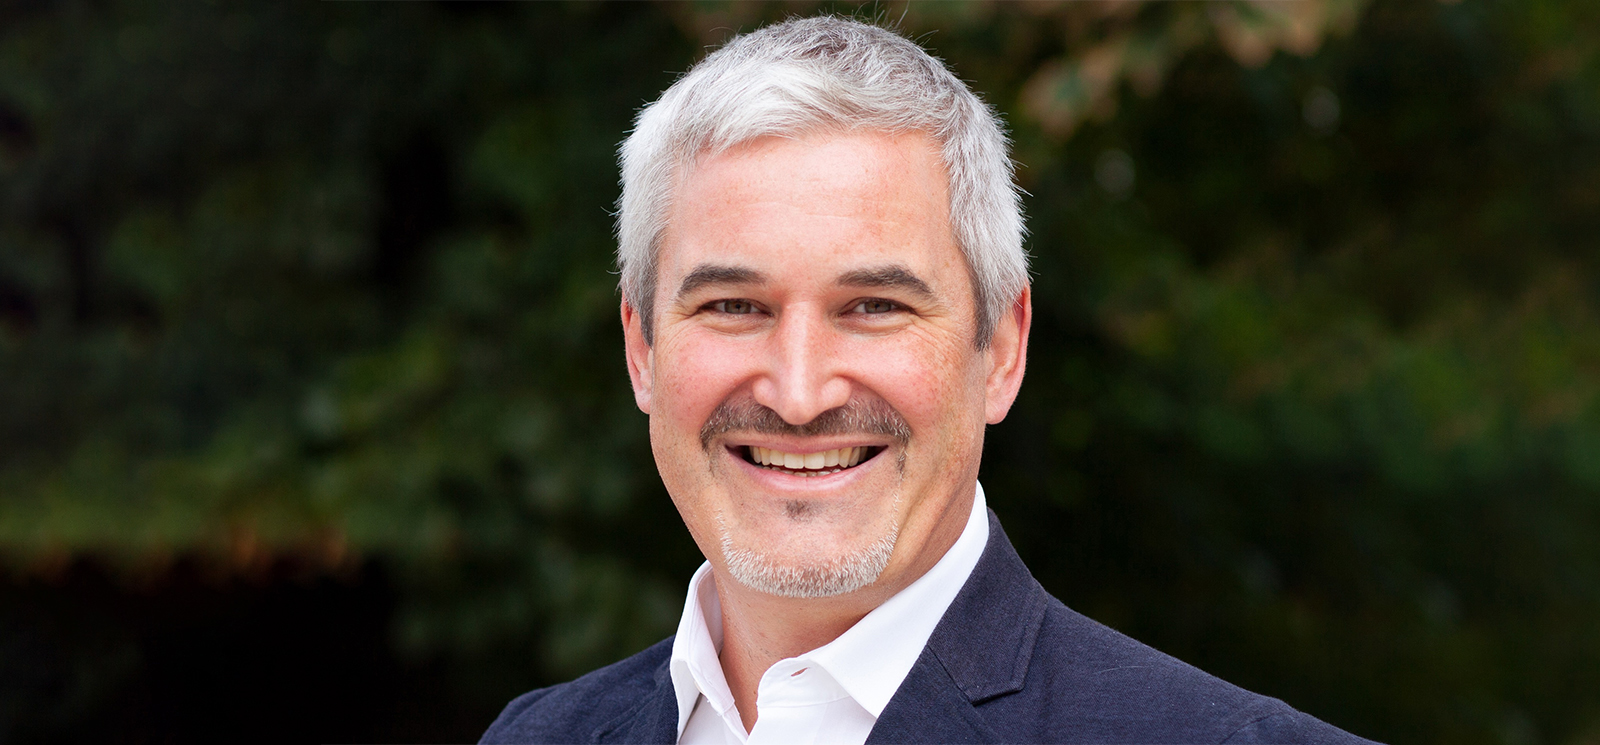
Foto: Kathrin Glückler
Die drei wesentlichen Learnings:
- Open Science bedeutet nicht zwingend, dass alle Daten vollständig frei verfügbar sein müssen. Gerade bei Unternehmensdaten, vertraulichen Informationen oder proprietären Quellen ist das oft nicht möglich. Entscheidend ist, Daten, Methoden, Verarbeitungsschritte und Einschränkungen so zu dokumentieren, dass andere die Forschung verstehen, prüfen und möglichst weiterverwenden können.
- BERD@NFDI verbindet Infrastruktur, Kompetenzaufbau und konkrete Forschungspraxis. BERD stellt nicht nur technische Dienste wie Repositorien oder Datenportale bereit. Das Konsortium verbindet diese Angebote mit Data Stewards, Schulungen, methodischer Unterstützung und KI-basierten Werkzeugen. Dadurch entsteht eine integrierte Infrastruktur, die Forschende dabei unterstützt, Daten zu finden, zu dokumentieren, rechtssicher zu nutzen und für andere nachnutzbar zu machen.
- Open Science hängt nicht allein vom Engagement einzelner Forschender ab. Notwendig sind verlässliche Repositorien, Data Stewards, Schulungsangebote, rechtliche Beratung und gut integrierte Forschungsinfrastrukturen. Erst solche Strukturen ermöglichen es, Daten und Methoden systematisch zu dokumentieren, zu teilen und nachzunutzen.
Was bedeutet Open Science für Sie persönlich? Wie wichtig ist Ihnen das?
UK: Für mich war Open Science eigentlich schon wichtig, bevor ich den Begriff überhaupt kannte. Mir ist irgendwann aufgefallen, dass ich im Grunde schon als Data Steward gearbeitet habe, lange bevor das so genannt wurde. Dieses Teilen von Daten, das Bereitstellen für andere und die Nachvollziehbarkeit von Forschung – das war für mich immer selbstverständlich.
Schon gegen Ende meines Studiums war ich an einer Absolventenbefragung hier an der Universität Mannheim beteiligt. Da ging es nicht nur darum, Daten zu erheben, sondern auch darum, sie so aufzubereiten, dass sie als Ressource weiter genutzt werden können. Später war das auch in verschiedenen Panelstudien ein zentrales Thema: Forschung so anzulegen, dass Daten nachhaltig verfügbar sind und möglichst viele andere Forschende damit arbeiten können.
Die Idee, Daten nur für sich selbst zu sammeln und dann nicht zugänglich zu machen, war mir ehrlich gesagt immer eher fremd. Erst später habe ich verstanden, dass Open Science noch viel mehr umfasst, zum Beispiel offene Publikationsformen oder Data Literacy. Aber die grundlegende Haltung war eigentlich schon immer da. Wenn man selbst forscht und etwas bereitstellt, sollte das möglichst auch anderen zugutekommen. Und ich glaube, genau darin liegt der Gewinn. Forschung wird besser, wenn mehr Menschen anschließen, mitdenken und weiterarbeiten können.
Und wenn Sie jetzt auf BERD@NFDI schauen: Was bedeutet Open Science für das Konsortium?
UK: Einzelne Aspekte von Open Science sind für uns sehr wichtig. Ich würde aber nicht sagen, dass BERD@NFDI ein Open-Science-Konsortium im ganz umfassenden Sinn ist. Wir beschäftigen uns zum Beispiel nicht direkt mit dem Thema Open Access oder offenem Publizieren. Unser Fokus liegt stärker auf dem Forschungsdatenmanagement, also darauf, Daten verständlich, auffindbar und gut nachnutzbar zu machen und diese Themen in die wirtschaftswissenschaftlichen Communities hineinzubringen.
Genau da gibt es aus meiner Sicht eine große Nähe zur Open-Science-Community. In der NFDI sprechen wir oft eher in Begriffen der FAIR-Prinzipien. Das ist auch der Bereich, in dem wir besonders stark unterwegs sind. Und deshalb sind die Open-Science-Officer und andere Open-Science-Akteur:innen an den Universitäten für uns ganz natürliche Verbündete. Das spürt man auch in der gemeinsamen Arbeit immer wieder. Wir bearbeiten also nicht alle Facetten von Open Science, aber wir treiben wichtige Teile davon sehr bewusst voran.
Das NFDI-Konsortium steht jetzt kurz vor dem Übergang von der Aufbauphase in die zweite Förderphase. Welche Bilanz ziehen Sie als Projektkoordinator aus der ersten Phase, und welche Ergebnisse sind für Sie besonders tragfähig?
UK: Wir stehen jetzt kurz vor der Entscheidung über die Weiterförderung von BERD. Aber unabhängig davon fällt meine Bilanz der ersten Phase positiv aus. Ich glaube, wir haben es geschafft, das Thema Forschungsdatenmanagement stärker in Communities hineinzubringen, für die das lange nicht überall selbstverständlich auf der Agenda stand. Man muss fairerweise sagen, dass das alles nicht ganz neu war, und es gab natürlich auch vorher schon wichtige Vorarbeiten, unter anderem von der ZBW. Aber ich denke schon, dass wir in den Wirtschaftswissenschaften einen zusätzlichen Impuls setzen konnten. Mein Eindruck ist, dass Themen wie Open Science, Nachnutzbarkeit von Daten und datenbezogene Infrastrukturen gerade deutlich an Fahrt aufnehmen.
Wenn wir dazu beigetragen haben, dass mehr Menschen in den wirtschaftswissenschaftlichen Fachcommunities das als wichtiges Thema sehen und verstehen, dass man hier mehr tun muss, dann ist das für mich schon ein großer Erfolg. Und besonders tragfähig finde ich, dass inzwischen in vielen Bereichen sehr viel klarer gesehen wird, wie wichtig datengetriebene Forschung ist. Spannend ist ja, dass einige Subdisziplinen im Kern längst datengetrieben arbeiten, ohne das immer so deutlich zu reflektieren. Genau dieses Bewusstsein weiter zu stärken, halte ich für einen zentralen Ertrag der ersten Förderphase.
Würden Sie sagen, dass das ein Verdienst von BERD ist? Oder greift die BWL auf der Suche nach neuer Legitimität stärker naturwissenschaftliche Standards auf?
UK: Ich glaube, da sind beide Seiten zusammengekommen. Auf der einen Seite gibt es in den Wirtschaftswissenschaften ganz klar eine Entwicklung hin zu mehr datengetriebener Forschung, mehr Transparenz und einem stärkeren Interesse an Fragen der Nachnutzbarkeit. Auf der anderen Seite hat BERD, denke ich, schon dazu beigetragen, diese Themen sichtbarer zu machen und ihnen einen konkreten Rahmen zu geben.
Das sieht man inzwischen auch ganz praktisch auf Tagungen oder in Arbeitsgruppen. Da ist schon einiges in Bewegung. Ich würde deshalb nicht sagen, dass BERD das alles allein angestoßen hat. Aber wir haben sicher dabei geholfen, diese Entwicklung aufzugreifen und weiterzutragen. Und wenn sich so etwas in der Mitte trifft – also bestehende Dynamiken in den Fachcommunities und ein Angebot wie BERD –, dann ist das eigentlich genau das Beste, was passieren kann. Für BERD selbst war die erste Phase natürlich auch stark Aufbauarbeit. Da ist eine neue Gruppe aus Forschenden und Infrastruktureinrichtungen in einer ganz neuen Konstellation zusammengekommen, und gleichzeitig musste sich auch die NFDI insgesamt erst einmal finden. Dass das gut gelungen ist, zeigen aus meiner Sicht auch die positiven Begutachtungen und die bisherigen Erfolge. Wichtig finde ich außerdem, dass wir den Wirtschaftswissenschaften in der NFDI eine Stimme geben. Es geht ja nicht nur um einzelne Services, sondern auch um Repräsentation, Sichtbarkeit und darum, dass dieser große Bereich der Forschungslandschaft dort seinen Platz hat. Und ich bin tatsächlich auch sehr stolz auf die konkreten Dienste, die wir aufgebaut haben, also auf Anwendungen, die Forschenden unmittelbar etwas bringen.
Was ist hier Ihr Favorit?
UK: Ein Favorit ist für mich auf jeden Fall das Datenrepositorium, das wir gemeinsam mit der ZBW aufgebaut haben. Ich finde das deshalb so wichtig, weil Forschungsdaten in der BWL bislang oft viel schwerer aufzufinden sind als zum Beispiel in der Politikwissenschaft oder in der Soziologie, wo es schon lange große und gut etablierte Survey-Strukturen gibt. Da mehr Transparenz zu schaffen und den Zugang zu Daten zu erleichtern, ist aus meiner Sicht ein echter Fortschritt. Spannend finde ich aber auch die neueren KI-gestützten Anwendungen. Wir arbeiten zum Beispiel daran, Inhalte aus Publikationen systematisch zu erschließen und methodische Informationen, etwa zur Nutzung bestimmter Preprocessing-Verfahren, semiautomatisch aus Fachartikeln zu extrahieren. Solche Anwendungen können helfen, Forschung nachvollziehbarer zu machen und methodische Entwicklungen besser sichtbar zu machen.
Sehr gut finde ich auch den neuen Dienst, mit dem wir Skalen aus der betriebswirtschaftlichen Forschung besser auffindbar gemacht haben. Daran sieht man, dass manchmal schon vergleichsweise kleine Lücken eine große praktische Hürde darstellen. Wenn solche Materialien bislang nur verstreut oder in schwer zugänglichen Bänden vorliegen, dann ist die Schwelle für die Nutzung hoch. Wenn man das digital durchsuchbar macht, ist sofort sehr viel gewonnen. Und wenn wir die letzten rechtlichen Fragen dazu noch lösen, dann ist das für mich wirklich ein schöner Erfolg. Und unsere BERD-Academy ist natürlich ebenfalls ein riesiger Pluspunkt. Dass dort so viele teilnehmen und die Rückmeldungen so positiv sind, zeigt sehr deutlich, dass in der Community ein echter Bedarf vorhanden ist.
Wenn Sie das Datenportal gegenüber der Fachcommunity beschreiben: Welches Problem soll es lösen, und worin liegt sein konkreter Mehrwert?
UK: Unser Ziel ist es, einen zentralen Hub für Datensätze zu schaffen, die insbesondere in den Wirtschaftswissenschaften relevant sind und bislang oft nur schwer auffindbar sind. Gerade in unserem Feld tauchen Daten häufig im Zusammenhang mit Publikationen auf, sind dann aber sehr verstreut abgelegt, sei es auf Journal-Servern, auf institutionellen Seiten oder an Orten, an denen sie nur mit großem Aufwand zu finden sind. Teilweise sind sie auch gar nicht systematisch nachgewiesen. Genau da sehen wir eine echte Lücke. Was wir mit dem Portal schaffen wollen, ist vor allem bessere Auffindbarkeit und mehr Transparenz. Forschende sollen nicht lange suchen müssen, wo Daten liegen und in welchem Zusammenhang sie genutzt wurden, sondern dafür einen zentralen Anlaufpunkt haben. Das ist aus meiner Sicht der eigentliche Mehrwert. Zugleich wollen wir mit dem Portal auch ein offenes, frei zugängliches Angebot schaffen, also eine Infrastruktur, die sich an den FAIR-Prinzipien orientiert und nicht von kommerziellen Interessen geprägt ist. Forschende sollen dort auch eigene Referenzdaten verlässlich ablegen können. Es geht also nicht nur darum, Vorhandenes sichtbarer zu machen, sondern auch darum, eine nachhaltige und vertrauenswürdige Umgebung für die Bereitstellung und Nachnutzung von Daten zu schaffen.
Mit der zweiten Förderphase von BERD verschiebt sich der Schwerpunkt stärker in Richtung Konsolidierung, Integration und Verstetigung. Was verändert sich dadurch konkret in Ihrer Arbeit? Und woran wird die BWL-Community merken, dass BERD in Phase zwei angekommen ist?
UK: In der ersten Phase haben wir viele Dinge aufgebaut, erprobt und in unterschiedliche Richtungen entwickelt. In der zweiten Phase geht es nun stärker darum, diese Angebote zusammenzuführen, besser zu integrieren und insgesamt verlässlicher zu machen. Für die Nutzenden heißt das im Idealfall, dass Dienste, die stabiler laufen, leichter verständlich sind, besser zusammenpassen und sich stärker an den tatsächlichen Bedürfnissen der Forschenden orientieren. Es geht also nicht nur darum, Bestehendes einfach fortzuführen, sondern es in eine Form zu bringen, die im Alltag wirklich trägt. Dazu gehören ganz praktische Fragen wie Stabilität, Performance und Nutzerfreundlichkeit, also letztlich auch das Look and Feel der BERD-Angebote. Gleichzeitig ist das keine reine Verwaltungs- oder Wartungsphase. Natürlich wollen wir auch gezielt weiterentwickeln und neue Themen aufnehmen. Ein wichtiger Bereich sind dabei die KI-basierten Anwendungen. Da geht es zum Beispiel um die Frage, wie Forschende ihre Daten leichter dokumentieren, Nutzungen besser nachweisen oder auch Publikationen effizienter vorbereiten können. Gerade solche Anwendungen werden in der zweiten Phase sicher noch stärkeres Gewicht bekommen.
Das heißt, es geht nicht nur um technische Konsolidierung, sondern auch um einen engeren Zusammenhang zwischen den einzelnen Angeboten?
UK: Genau. Konsolidierung heißt für uns immer auch, die bestehenden Dienste besser miteinander zu vernetzen. Das Ziel ist, dass Forschende nicht mehr an vielen verschiedenen Stellen ansetzen müssen, sondern mit einer konkreten Fragestellung zu BERD kommen und dann von dort aus möglichst viel finden. Das heißt, Daten, Werkzeuge, Schulungsangebote und methodische Unterstützung. Dieser integrierte Zugang ist im Grunde die Leitidee.
Gleichzeitig haben wir gelernt, dass solche Integration nicht nur eine technische, sondern auch eine organisatorische Aufgabe ist. Wir haben in der ersten Phase unterschätzt, wie groß der Kommunikations- und Abstimmungsaufwand ist. Sowohl innerhalb von BERD selbst, aber auch im Austausch mit der gesamten NFDI. Daran passen wir jetzt unsere Strukturen an, mit klareren Zuständigkeiten und einem internen Management, das effizienter funktionieren soll. Für die BWL-Community ist das vielleicht nicht immer unmittelbar sichtbar, weil vieles davon unter der Haube passiert. Aber genau diese Arbeit ist entscheidend, damit die Angebote langfristig tragfähig werden. Und sie ist auch deshalb wichtig, weil wir die BERD-Dienste stärker mit anderen NFDI-Konsortien verknüpfen und in die verstetigte NFDI einbetten müssen. Für die BWL-Community sollte sich Phase zwei deshalb vor allem darin bemerkbar machen, dass BERD als Infrastruktur geschlossener, verlässlicher und im Forschungsalltag selbstverständlicher nutzbar wird.
Wenn wir über Verstetigung und Konsolidierung sprechen, stellt sich zwangsläufig auch die langfristige Frage. Wie sieht BERD oder die NFDI-Perspektive in zehn Jahren aus? Und wie kann eine solche Infrastruktur auf Dauer finanziert und getragen werden?
UK: Für die nächsten zehn Jahre gibt es schon eine recht klare Perspektive. Ziel ist eine dauerhaft etablierte nationale Forschungsinfrastruktur. Die einzelnen Konsortien werden dabei voraussichtlich stärker in größere Strukturen eingebunden sein, und mehr Angebote werden als gemeinsame NFDI-Services betrieben und nicht mehr nur als Dienste einzelner Konsortien.
Und wer finanziert das langfristig?
UK: Die Finanzierung soll auch langfristig überwiegend öffentlich getragen werden, grundsätzlich zu 90 Prozent vom Bund und zu 10 Prozent von den Ländern. Der größte Teil mit circa 80 Prozent ist für den Betrieb bestehender Dienste, ihre Stabilisierung und die Arbeit mit den Communities vorgesehen. Ein kleinerer Teil von rund 20 Prozent soll gezielt Innovation ermöglichen. Gleichzeitig wird der NFDI-Verein künftig eine stärkere Rolle in der Steuerung übernehmen. Die Herausforderung wird darin liegen, mehr strategische Koordination zu schaffen und zugleich die Zusammenarbeit mit Einrichtungen wie der ZBW, GESIS oder den Universitäten weiter eng einzubinden.
Lassen Sie uns noch über KI sprechen. Auf Ihrer Website steht „Data4AI“ und „AI4Data“. KI ist also klar ein Schwerpunkt. Was bedeuten in diesem Zusammenhang Datenschutz, Vertraulichkeit und Open Science? Und wie lässt sich der Konflikt zwischen Offenheit auf der einen und wirtschaftlichen Interessen auf der anderen Seite aus Ihrer Sicht lösen?
UK: KI ist für uns ganz klar ein wichtiges Thema, und zwar nicht nur wegen ihrer Leistungsfähigkeit, sondern auch wegen der rechtlichen und infrastrukturellen Fragen, die damit verbunden sind. Gerade bei Datenschutz, Vertraulichkeit und Urheberrecht gibt es reale Grenzen, die man in der Forschung nicht einfach ignorieren kann. Deshalb geht es aus meiner Sicht nicht nur darum, die jeweils leistungsstärksten Modelle zu nutzen, sondern darum zu zeigen, wie man zugleich leistungsfähig und rechtssicher arbeiten kann. Genau darin sehe ich auch eine Aufgabe von Infrastruktureinrichtungen. Es geht darum, Forschende nicht allein zu lassen, sondern sie mit Schulung, Orientierung und gegebenenfalls auch rechtlicher Unterstützung zu begleiten. Das ist ein Spannungsfeld, weil natürlich viele erst einmal das stärkste verfügbare Modell nutzen wollen.
Ihre Antwort zielt also darauf, dass man KI in der Forschung nicht einfach nur nutzen, sondern ihren Einsatz auch sauber dokumentieren muss. Ist genau das der Punkt, an dem Open Science und die Nutzung kommerzieller KI-Allrounder in Spannung geraten?
UK: Ja, genau das ist ein zentraler Punkt. Uns geht es gerade darum, diese Lücke zu schließen, also besser zu dokumentieren, welche algorithmischen Methoden eigentlich verwendet wurden und wie ihr Einsatz in der Forschung nachvollziehbar gemacht werden kann. Dafür wollen wir Forschenden ganz konkrete Hilfestellungen geben. Ein Beispiel dafür ist unser neuer Dienst Guide-LLM. Das ist im Kern eine Art Checkliste dafür, was dokumentiert werden sollte, wenn Large Language Models in der Forschung eingesetzt werden. Denn das Problem ist ja offensichtlich. Viele nutzen diese Systeme bereits, aber die Transparenz darüber, was genau mit welchen Einstellungen und auf welcher Grundlage passiert ist, reicht oft noch nicht aus. Unser Anspruch ist deshalb nicht unbedingt, jede Nutzung durch eigene Modelle zu ersetzen. Aber wir wollen dazu beitragen, dass der Einsatz von KI methodisch sauberer, dokumentierbarer und damit auch besser mit wissenschaftlichen Standards vereinbar wird.
Und das reicht aus Ihrer Sicht schon, um den Konflikt mit Open Science zu entschärfen?
UK: Es ist ein erster Schritt, aber natürlich nicht die ganze Lösung. Schwieriger wird es dort, wo Nachvollziehbarkeit und Reproduzierbarkeit davon abhängen, dass andere Forschende sich dieselben kommerziellen Werkzeuge oder Lizenzen leisten können. Das ist aus Open-Science-Perspektive problematisch. In gewisser Weise erinnert das an die ältere Diskussion über proprietäre und offene Statistiksoftware, nur dass sie sich mit LLMs jetzt noch einmal verschärft. Deshalb schauen wir auch, ob sich an manchen Stellen selbst gehostete Modelle einsetzen lassen, zum Teil aus urheberrechtlichen Gründen, zum Teil aber auch im Interesse wissenschaftlicher Souveränität. Entscheidend ist dann natürlich, ob diese Modelle für den jeweiligen Zweck leistungsfähig genug sind. Wenn das der Fall ist, passt das sehr viel besser zu einem Open-Science-Verständnis. Am Ende wird man die Blackbox nicht in jedem Fall ganz auflösen können. Aber man kann und muss ihren Einsatz so dokumentieren, dass Forschung intersubjektiv nachvollziehbar bleibt. Und ich glaube, dieses Bewusstsein setzt sich inzwischen auch zunehmend durch.
Sie haben vorhin angedeutet, wie wichtig der Austausch innerhalb der NFDI ist. Wie sieht diese Zusammenarbeit beim Thema KI konkret aus? Entwickeln die Konsortien da gemeinsame Linien, oder passiert das eher punktuell?
UK: Was die Zusammenarbeit mit anderen Konsortien angeht, gibt es auf jeden Fall Austausch. Wir hatten zum Beispiel vor Kurzem einen größeren internationalen Workshop, bei dem es um den Einsatz von LLMs in wissenschaftlichen Publikationen ging. Dabei standen vor allem ethische und rechtliche Fragen im Vordergrund, also genau die Themen, die viele Konsortien gerade gleichermaßen beschäftigen. Darüber hinaus entsteht Zusammenarbeit oft dort, wo man merkt, dass sich fachliche Interessen oder methodische Fragen überschneiden. Mit Konsortien, die thematisch oder methodisch nah an uns sind, ist der Austausch entsprechend enger. Gerade bei textanalytischen Verfahren gibt es zum Beispiel Berührungspunkte mit anderen Bereichen, die ähnliche Methoden nutzen und deshalb vor ähnlichen Fragen stehen. Ich würde aber nicht sagen, dass es schon so etwas wie eine einheitliche, konsortienübergreifende KI-Strategie in der NFDI gibt. Im Moment sind das eher gezielte, punktuelle Kooperationen, dort, wo sie fachlich sinnvoll sind und wo man merkt, dass sich Probleme oder Interessen tatsächlich überschneiden.
Was bedeutet das Thema Data Literacy im Kontext von BERD ganz konkret? Und an welchen Stellen bauen Sie gezielt Kompetenzen auf, weil Sie sehen, dass dort noch Lücken bestehen?
UK: Wir bündeln unsere Angebote zu Data Literacy unter dem Dach der BERD Academy. Dort gibt es zum einen Formate für Forschende selbst, zum anderen aber auch Angebote für Multiplikator:innen, also etwa im Sinne von Train-the-Trainer. Unser Ansatz ist dabei, sehr genau auf die Bedarfe in den Communities zu schauen. Was wird gerade gebraucht, welche methodischen Entwicklungen zeichnen sich ab, und wo entstehen neue Anforderungen durch technische Entwicklungen? Daraus entwickeln wir dann möglichst konkrete und anwendungsnahe Angebote. Ein wichtiger Punkt ist für uns, dass Data Literacy nicht nur abstraktes Methodenwissen bleibt, sondern sich eng an der Forschungspraxis orientiert. Deshalb haben wir auch viele Hands-on Workshops gemacht, in denen Forschende mit ihren eigenen Daten gearbeitet haben. Da ging es dann nicht nur darum, bestimmte Tools kennenzulernen, sondern vor allem um die praktische Frage, wie ich datengetriebene Forschung nachvollziehbar mache. Wie dokumentiere ich meine Schritte so, dass andere sie verstehen und im besten Fall auch nachnutzen können?
Die BWL arbeitet besonders häufig mit Unternehmensdaten, Plattformdaten, unstrukturierten Daten und teils auch mit vertraulichen Datensätzen. Braucht es dafür noch einmal eine spezifische Form von Data Literacy?
UK: Ja, ich würde schon sagen, dass sich in der BWL noch einmal besondere Anforderungen stellen. Eine zentrale Herausforderung ist, dass viele mit proprietären oder vertraulichen Datensätzen arbeiten. Genau das macht Fragen der Dokumentation und Nachvollziehbarkeit deutlich schwieriger als in Bereichen, in denen Daten stärker standardisiert oder öffentlich verfügbar sind. Hinzu kommt, dass der Zugang zu solchen Daten oft sehr informell organisiert ist, beispielsweise über persönliche Kontakte zu Unternehmen, die vielleicht der Doktorvater hergestellt hat. Das ist in der Praxis natürlich häufig der Weg, auf dem Forschung überhaupt erst möglich wird. Gleichzeitig stellt sich dann aber umso dringlicher die Frage, was das eigentlich für ein Datensatz ist. Wie kann ich ihn so dokumentieren, dass meine Forschung nachvollziehbar bleibt? Und wie kann ich vielleicht Formen finden, zumindest die Analyse oder eine synthetische Version der Daten zugänglich zu machen, ohne Vertraulichkeit zu verletzen
Braucht die BWL im Umgang mit solchen Daten also nicht nur methodische, sondern auch besondere kommunikative und kooperative Kompetenzen, gerade dann, wenn der Zugang zu Unternehmensdaten über Beziehungen, Vertrauen und oft auch über längere Anbahnungsprozesse entsteht?
UK: Ich bin selbst kein BWLer, aber mein Eindruck ist, dass der Zugang zu Daten oft gar nicht das eigentliche Hauptproblem ist. Es gibt vielfach mehr Daten, als am Ende tatsächlich systematisch ausgewertet werden können. Der Zugang entsteht häufig über Praktika, Kooperationen oder persönliche Kontakte. Die eigentliche Herausforderung liegt eher darin, mit den Bedingungen solcher Daten professionell umzugehen. Wer mit Unternehmensdaten arbeitet, muss verstehen, dass in den Unternehmen andere Erwartungen an Vertraulichkeit, Dokumentation und Nutzung gelten als etwa in einem Forschungsdatenzentrum. Unternehmen liefern Daten oft nicht in einem Format, das unmittelbar auf wissenschaftliche Nachnutzung ausgerichtet ist, und sie tun das häufig auch mit eigenen Interessen, sei es mit Blick auf Sichtbarkeit, Kooperation oder mögliche Erkenntnisgewinne.
Wer mit Unternehmensdaten arbeitet, muss verstehen, dass dort oft ein ganz anderes Mindset herrscht als im klassischen wissenschaftlichen Datenkontext. Der Normalfall ist zunächst einmal nicht, dass Daten geteilt werden, sondern eher das Gegenteil. Daten gelten als sensibel, als geschäftsrelevant, womöglich auch als rechtlich heikel. Der Ausgangspunkt ist also oft erst einmal Zurückhaltung. Wenn dann trotzdem jemand in einem Unternehmen entscheidet, Forschenden Zugriff zu geben, ist das ein riesiger Schritt. Dafür braucht es auf Unternehmensseite Vertrauen, manchmal auch Mut und sicher ein gewisses Verständnis dafür, wie Wissenschaft arbeitet und warum solche Kooperationen sinnvoll sein können. Diese besondere Konstellation mitzudenken, halte ich für einen wichtigen Teil von Data Literacy in der BWL.
Wenn der Zugang zu Unternehmensdaten oft von Vertrauen und persönlicher Offenheit abhängt, müsste man dann nicht schon im BWL-Studium stärker dafür sensibilisieren, dass Datenteilen und wissenschaftliche Kooperation etwas Wertvolles sind? So dass die Türöffner in den Unternehmen immer mehr werden?
UK: Ja, das ist ein wichtiger Punkt. Im Grunde geht es darum, schon früh ein Verständnis zu fördern, das in Richtung Open Science weist. Wenn Daten vorhanden sind, sollte die erste Idee nicht sein, sie nur im engsten akademischen Umfeld weiterzugeben, sondern breiter zu denken und sie für wissenschaftliche Kooperationen zugänglich zu machen. Das ist sicher ein Kulturwandel, und deshalb ist die Phase des Studiums auch so wichtig. Ich hoffe, dass künftig mehr Studierende selbst erleben, wie hilfreich es sein kann, wenn es dafür verlässliche Strukturen gibt, etwa über den BERD Data Marketplace, wo man gezielter mit Unternehmen in Kontakt kommen und Kooperationen anbahnen kann. Wenn solche Erfahrungen häufiger werden, kann das langfristig auch die Wissenschaft-Praxis-Zusammenarbeit verändern. Nicht, weil frühere Wege grundsätzlich falsch gewesen wären, sondern weil sich nach und nach ein breiteres Verständnis dafür entwickelt, wie Datenzugang in der Forschung offener und strukturierter organisiert werden kann.
Wenn wir noch einmal auf KI schauen, verändert diese ja nicht nur Werkzeuge, sondern womöglich den ganzen Forschungsprozess. Was bedeutet dies für Data Literacy? Reicht es, wenn Forschende lernen, solche Systeme praktisch zu nutzen oder müssen sie auch verstehen, wie diese Modelle funktionieren, trainiert werden und welche Grenzen sie haben?
UK: Ich glaube, wir stehen da wirklich erst am Anfang einer Entwicklung, die sehr vieles verändern wird. Schon jetzt sieht man, dass KI nicht nur einzelne Arbeitsschritte beschleunigt, sondern auch verändert, wie Forschungsfragen formuliert, bearbeitet und in Texte übersetzt werden. Dadurch werden bestimmte Tätigkeiten für viel mehr Menschen zugänglich, und das verändert zwangsläufig auch die Anforderungen an Data Literacy.
Deshalb reicht es aus meiner Sicht nicht, nur zu lernen, wie man solche Systeme bedient. Forschende müssen auch ein grundlegendes Verständnis dafür entwickeln, wie diese Modelle funktionieren, wer sie bereitstellt, welche Interessen damit verbunden sind und was sie leisten können, aber eben auch, was sie nicht leisten können. Gerade dieser kritische Teil darf nicht in den Hintergrund geraten. Man sieht ja schon, wie weit das gehen kann. Mir hat neulich jemand von einem Beispiel aus der Informatik erzählt, wo mit agentischen Verfahren systematisch Paper nach Formulierungen wie „more research is necessary“ durchsucht wurden, daraus Forschungslücken gesammelt, priorisiert, passende Daten gesucht, Hypothesen formuliert und auf dieser Basis ganze Paper-Entwürfe erstellt. Das ist einerseits beeindruckend, zeigt aber eben auch, wie stark sich Forschungsprozesse gerade verändern.
Wäre zukünftig ein arbeitsteiliges Modell denkbar, in dem erfahrene Forschende vor allem relevante Fragen auswählen und hybride Teams aus KI und wissenschaftlichen Mitarbeitenden daraus Studien und Publikationen entwickeln?
UK: Das kann ich mir für bestimmte Arten von Forschung durchaus vorstellen. Vor allem Arbeiten, die bislang viel Zeit für Datenaufbereitung, Codierung oder das Erlernen einzelner Methoden erfordern, könnten deutlich effizienter werden. In den Sozialwissenschaften verbringen Promovierende teilweise Monate oder Jahre damit, Datensätze in eine analysierbare Form zu bringen. Ein Teil dieser Fleißarbeit dürfte künftig entfallen.
Wäre das ein Verlust für die Wissenschaft?
UK: Nicht zwangsläufig. Im besten Fall gewinnen Forschende dadurch mehr Zeit für die eigentliche wissenschaftliche Arbeit, sprich die Einordnung und Interpretation. Was bedeuten die Ergebnisse? Wie lassen sie sich in einen größeren Zusammenhang einordnen? Welche Folgen haben sie für andere Forschungsfelder oder für die Gesellschaft? Gute Wissenschaft besteht nicht allein darin, Daten zu bearbeiten und Methoden anzuwenden. Entscheidend ist die Fähigkeit, Befunde zu interpretieren, Zusammenhänge zu erkennen und relevante Fragen zu stellen. Diese Arbeit wird nicht überflüssig.
Wo läge dann die Grenze des Einsatzes von KI?
UK: Problematisch wird es, wenn wir glauben, auch den Erkenntnisgewinn selbst an Maschinen auslagern zu können. KI kann Forschende bei Routinen, Analysen und der Strukturierung von Wissen unterstützen. Sie ersetzt aber nicht die wissenschaftliche Urteilskraft, das heißt die Entscheidung, welche Frage wichtig ist, wie ein Ergebnis einzuordnen ist und welche Schlussfolgerungen daraus gezogen werden können.
Sie arbeiten als empirischer Sozialforscher in der AG Open Science des VHB. Mit welcher persönlichen Vision gehen Sie in diese Arbeitsgruppe?
UK: Früher hatte ich manchmal die Vorstellung, eine Förderorganisation wie die DFG müsse Open Science einfach verbindlich vorschreiben. Das wäre bequem, wird aber vermutlich nicht passieren. Deshalb möchte ich zunächst zuhören und besser verstehen, welche Probleme und Vorbehalte die Forschenden in der BWL beschäftigen. Schon bei der letzten Tagung fand ich es sehr aufschlussreich, diese Perspektiven kennenzulernen, weil ich selbst aus einer anderen Fachtradition komme.
Sie sind im VHB zugleich eine Art fachlicher Grenzgänger. Sehen Sie sich eher als Vermittler oder als jemand, der bewusst eine neue Perspektive einbringt?
UK: Eher als Brückenbauer. Aus meiner Arbeit in der NFDI kenne ich viele Disziplinen, und die grundlegenden Herausforderungen ähneln sich stärker, als man zunächst denkt. Die Unterschiede liegen oft im Detail. In der BWL spielen beispielsweise proprietäre Daten und Geschäftsgeheimnisse eine größere Rolle. In der Medizin stehen dagegen häufig personenbezogene und besonders sensible Daten im Vordergrund. Dennoch geht es überall um ähnliche Fragen: Wie lassen sich Daten teilen? Wie gehen wir mit Fehlern um? Welche Anreize brauchen Forschende?
Können die Disziplinen voneinander lernen?
UK: Unbedingt. Allerdings sollte man keine Disziplin idealisieren. In einer Sitzung hieß es etwa, eine bestimmte Fachdisziplin sei bei Open Science besonders weit. Gleichzeitig haben mir mehrere Kolleg:innen gerade aus diesem Fach erzählt, dass es dort erhebliche Probleme gäbe, etwa mit der Fehlerkultur. Deshalb wäre es falsch zu sagen, dass eine Disziplin die Lösung gefunden hat und die anderen sie nur übernehmen müssen. Sinnvoller ist es, über Fachgrenzen hinweg zu vergleichen, aus den Erfahrungen anderer zu lernen und deren Fehler nicht zu wiederholen. Ganz vermeiden werden wir neue Fehler trotzdem nicht – aber wir können informierter mit ihnen umgehen.
Woran würden Sie erkennen, dass die AG Open Science des VHB erfolgreich arbeitet?
UK: Für mich wäre entscheidend, dass nachhaltige Prozesse und Strukturen entstehen. Wir sollten nicht den Anspruch haben, sofort alles vollständig und perfekt offen zu gestalten. Wichtiger ist, etwas auszuprobieren, daraus zu lernen und erfolgreiche Ansätze schrittweise auszubauen. Ein weiteres Erfolgskriterium wäre, das Bewusstsein für Open Science in der BWL zu stärken. Noch wichtiger ist mir aber, dass die AG nicht nur eine vorübergehende Initiative eines einzelnen VHB-Vorstands bleibt. Open Science sollte dauerhaft im Verband verankert sein und auch über personelle Wechsel hinweg weitergeführt werden.
Vielen Dank!
Das Interview wurde am 26. Juni 2026 geführt von Dr. Doreen Siegfried.
Über Dr. Ulrich Krieger:
Dr. Ulrich Krieger ist Managing Director des Konsortiums BERD@NFDI an der Universitätsbibliothek Mannheim. Das Konsortium entwickelt eine Forschungsdateninfrastruktur für Wirtschafts-, Sozial- und Verhaltenswissenschaften mit besonderem Fokus auf unstrukturierte Daten. Der Sozialwissenschaftler verfügt über langjährige Erfahrung in der empirischen Umfrageforschung. In seiner heutigen Arbeit verbindet Krieger survey-methodische Expertise mit Forschungsdatenmanagement und Data Literacy. Er vermittelt unter anderem, wie Forschungsfragen, Datenqualität und die FAIR-Prinzipien zusammenspielen, und setzt sich für eine offene, nachvollziehbare und nachnutzbare Forschungspraxis ein. Darüber hinaus ist er Mitglied in der AG Open Science des VHB.
Kontakt: https://www.bib.uni-mannheim.de/ihre-ub/ansprechpersonen/dr-ulrich-krieger/
ORCID.ID: https://orcid.org/0000-0001-6705-7464
LinkedIn: https://www.linkedin.com/in/ulrich-krieger-ma/